Resumo rapido
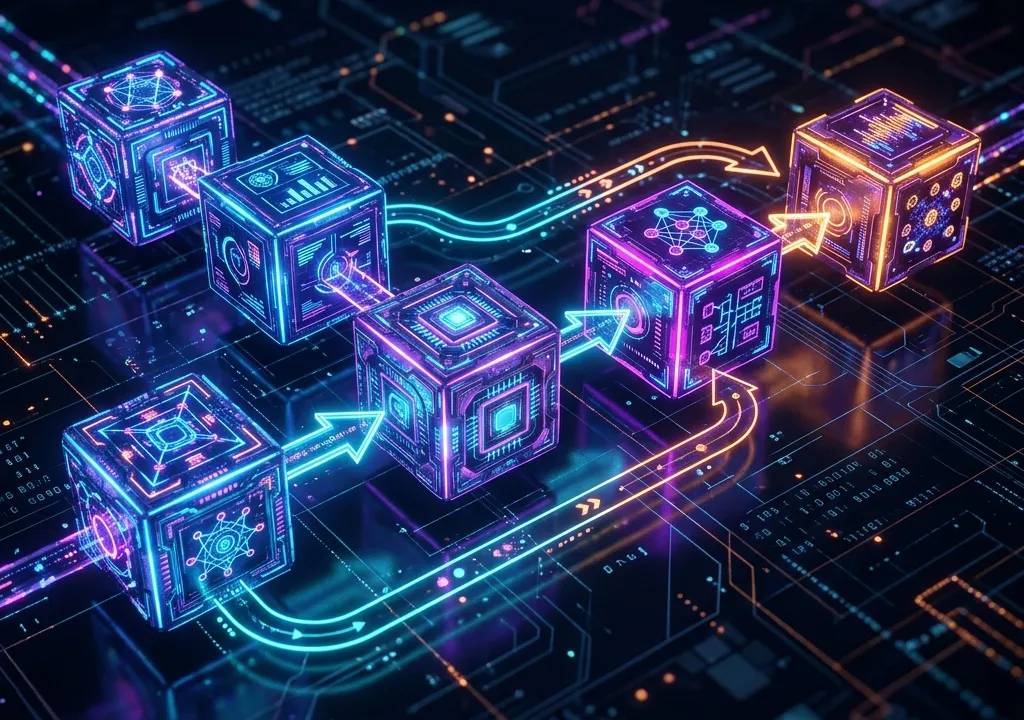
O Prompt Chaining (encadeamento de prompts) consiste em dividir uma instrução complexa em várias subetapas sequenciais. A saída gerada por um modelo de linguagem (LLM) serve diretamente de entrada para o prompt seguinte. Isso reduz a probabilidade de alucinação do modelo, simplifica a depuração do código e eleva a precisão técnica em tarefas automatizadas.
Divisão de Tarefas: Mitigando a Perda de Atenção dos Modelos
Quando pedimos para um modelo executar muitas ações difíceis em um único prompt longo (como “leia esta página de código, identifique os bugs, reescreva de forma otimizada e crie a documentação”), a inteligência artificial costuma ignorar instruções intermediárias.
Ao aplicar o encadeamento, dividimos a carga de trabalho em estágios:
- Primeira Etapa: O modelo apenas lista os pontos problemáticos do código.
- Segunda Etapa: Consome a lista gerada anteriormente e reescreve os blocos apontados.
- Terceira Etapa: Redige a documentação com base exclusiva no código final otimizado.
Essa divisão torna a execução do código de apoio muito mais previsível, o que é fundamental ao usar assistentes que auxiliam na codificação como o DeepSeek Coder no VSCode.
Roteiro de Orquestração e Validação Estrita de Saídas (JSON)
Para construir pipelines funcionais de encadeamento sem acumular erros entre as etapas, siga estas diretrizes:
- Controle de Tokens: Transmita apenas as informações estritamente necessárias para o passo seguinte, evitando estourar a memória de trabalho do modelo.
- Formatação Estruturada: Exija saídas em JSON para facilitar a validação e conversão dos dados no código de back-end. A persistência dessas informações de forma nativa e rápida pode ser feita usando ferramentas integradas como o Astro DB para gerenciar dados relacionais.
Um benefício lateral dessa arquitetura é que, ao validar as entradas em cada barreira intermediária do pipeline, os desenvolvedores criam travas de segurança eficazes e aprendem como se proteger de prompt injection de forma natural na aplicação.
Conclusão: Por que o futuro dos prompts está na orquestração
Minha leitura é que tentar criar o “prompt perfeito de uma única tentativa” é um erro de engenharia. Em produção, a confiabilidade de sistemas de inteligência artificial depende de uma arquitetura modular. Dividir e encadear tarefas é o caminho mais sólido para construir fluxos de trabalho autônomos e previsíveis em software corporativo hoje.
Leia tambem
- Como se Proteger de Prompt Injection em Sistemas de IA
- Como Usar o DeepSeek Coder no VSCode para Programação
- Como Usar o Astro DB para Gerenciar Banco de Dados