Executar modelos de linguagem (LLMs) como Llama 3.3, Mistral Small e geradores de imagem como Flux 1 localmente tornou-se uma prática padrão para desenvolvedores e empresas preocupadas com privacidade de dados e custos repetitivos de API. No entanto, a escolha da placa de vídeo para esse propósito segue regras muito diferentes das métricas de jogos tradicionais.
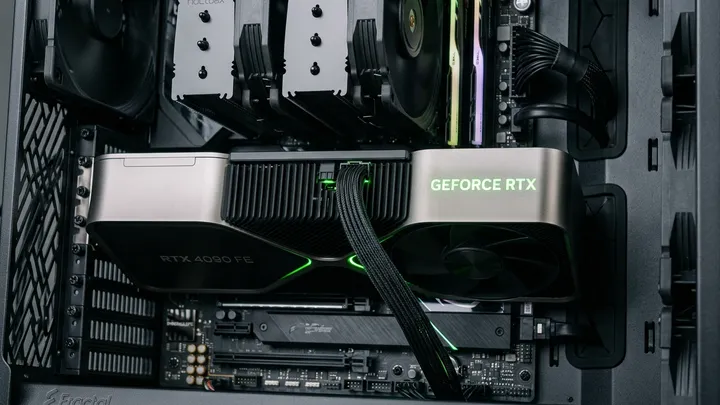
No cenário atual de hardware, a discussão central contrapõe a topo de linha da geração anterior, a NVIDIA GeForce RTX 4090 (com seus expressivos 24GB de VRAM GDDR6X), e a recém-chegada GeForce RTX 5080 (equipada com 16GB de VRAM GDDR7 de altíssima velocidade).
VRAM total vs Largura de banda: O que importa para LLMs e quantização?
No processamento local de linguagem via frameworks como Ollama, LM Studio ou vLLM, a limitação primária não é o poder bruto de cálculo dos núcleos CUDA, mas sim a capacidade da VRAM de abrigar os parâmetros do modelo e o contexto da conversa (KV Cache).
- RTX 4090 (24 GB GDDR6X): Com barramento de 384 bits e largura de banda de 1.008 GB/s, permite rodar modelos de 30 a 70 bilhões de parâmetros quantizados em Q4_K_M inteiramente na memória de vídeo sem depender do transbordo lento para a RAM do sistema.
- RTX 5080 (16 GB GDDR7): Embora limitada a 16 GB, o novo barramento GDDR7 entrega uma largura de banda superior a 1.200 GB/s. Isso significa que modelos menores (como 8B e 14B de parâmetros) rodam com taxa de geração de tokens significativamente mais rápida.
Se o seu trabalho envolve agentes locais integrados a ferramentas de código como o Claude Code no terminal para automação, a velocidade de saída de tokens da RTX 5080 em modelos de 8B e 14B entrega uma sensação de resposta instantânea imbatível.
Desempenho prático em geração de imagens e fine-tuning (Stable Diffusion e Flux)
Ao migrar para workflows de síntese visual com SDXL, ComfyUI e Flux 1.0 Dev, a exigência de memória atinge picos elevados.
| Cenário de Uso | RTX 4090 (24GB GDDR6X) | RTX 5080 (16GB GDDR7) | Vencedora Recomendada |
|---|---|---|---|
| Geração em lote no Flux 1 Dev (FP16) | Carrega a unet inteira na VRAM (12s por imagem 1024x1024). | Exige quantização FP8 para não estourar a VRAM (14s por imagem). | RTX 4090 (Pelo espaço VRAM). |
| Fine-tuning LoRA em SDXL | Permite batch size 4 sem otimizações agressivas de swap. | Exige gradiente checkpointing ativo e batch size 2. | RTX 4090 (Permite treinos maiores). |
| Inferência em modelos 8B quantizados (Q8) | ~75 tokens/segundo. | ~105 tokens/segundo. | RTX 5080 (Pela largura GDDR7). |
Note que a evolução dos chips gráficos não afeta apenas o mercado de PCs de alta performance, mas redefiniu também os padrões de arquitetura de consoles de última geração, como vimos nos avanços do processamento de sinal do PlayStation 5 Pro e sua GPU otimizada.
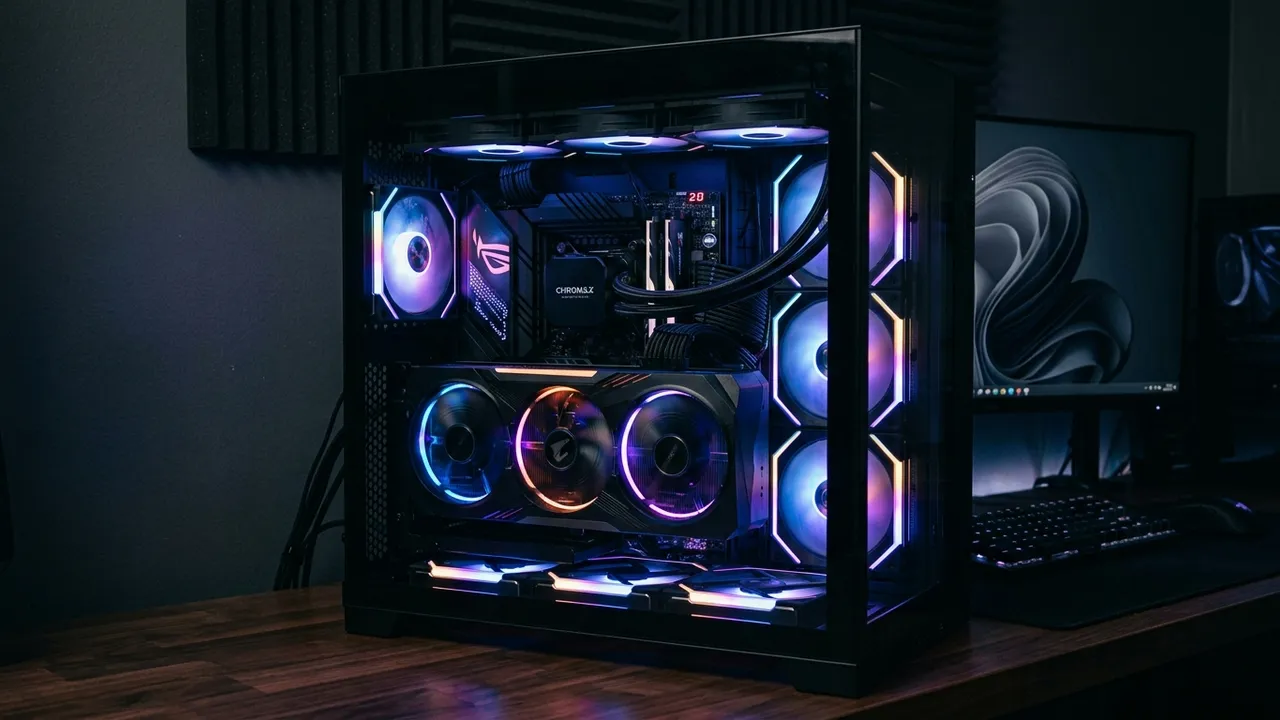
Qual placa escolher para a sua estação de trabalho?
A decisão final depende diretamente do tamanho dos modelos que você pretende executar no seu dia a dia:
- Escolha a RTX 4090 se: Seu objetivo principal é rodar modelos de linguagem grandes (32B a 70B quantizados), criar pipelines complexas no ComfyUI com múltiplos ControlNets ativos simultaneamente ou realizar treinamento local de pesos LoRA.
- Escolha a RTX 5080 se: Seu trabalho foca em desenvolvimento de software com modelos de suporte rápido (até 14B de parâmetros), você busca menor consumo de energia e menor emissão de calor no ambiente de trabalho, e prefere adquirir um componente com garantia integral de fábrica e suporte às bibliotecas CUDA mais recentes.